Как тестировать системы, которые активно используют большие языковые модели (LLM)
Артем Петров
13 мин
15 сентября 2026
Дата публикации
Тестирование ПО
Обеспечение качества
Большие языковые модели (Large Language Models, LLM) постепенно становятся обычной частью корпоративных систем. Они отвечают клиентам, ищут информацию во внутренних базах знаний, помогают работать с документами, анализируют обращения и все чаще участвуют в бизнес-процессах.
Но система может работать технически исправно, API возвращает 200 OK, интеграции доступны, интерфейс не падает, а пользователь получает неверный результат. Для бизнеса это означает, что привычного подхода к тестированию уже недостаточно. О том, почему для ИИ-систем привычного контроля качества уже недостаточно, мы подробнее рассказывали в статье «Тестирование ИИ-систем: чему бизнесу важно научиться в 2026 году».
Почему обычных тест-кейсов становится мало
В классическом приложении ожидаемый результат чаще всего известен заранее. Нажали кнопку — открылась нужная страница. Отправили платеж — получили определенный статус. С LLM все сложнее.
Представим корпоративного ассистента, которому задают вопрос: «Можно ли вернуть товар через 20 дней после покупки?»
В базе знаний указан срок 14 дней. Ассистент может назвать его правильно, придумать исключение, которого в правилах нет, или сформулировать ответ настолько двусмысленно, что клиент поймет его неправильно. И во всех трех случаях приложение продолжит исправно работать. При тестировании LLM-систем нужно оценивать результат глазами пользователя и бизнеса, включая последствия ответа.
Перед запуском LLM-системы важно знать, где ей пока нельзя доверять
Что на самом деле нужно тестировать в системе с LLM
Одна из распространенных ошибок — сосредоточиться на самой языковой модели: насколько хорошо она отвечает на вопросы, понимает ли инструкции, сохраняет ли контекст.
Представим ассистента страховой компании. Клиент спрашивает, покрывает ли его полис определенный случай. Чтобы ответить, система должна понять вопрос, найти условия конкретного продукта, выбрать актуальную редакцию документа, извлечь нужный фрагмент, передать его модели, сформировать ответ и, возможно, предложить дальнейшее действие.
Ошибка способна появиться на любом этапе.
Особенно это заметно в системах с RAG (Retrieval-Augmented Generation — генерация с дополнением из внешних источников). Модель может корректно обработать полученный контекст, но если поиск передал ей устаревший документ, ответ тоже окажется устаревшим.
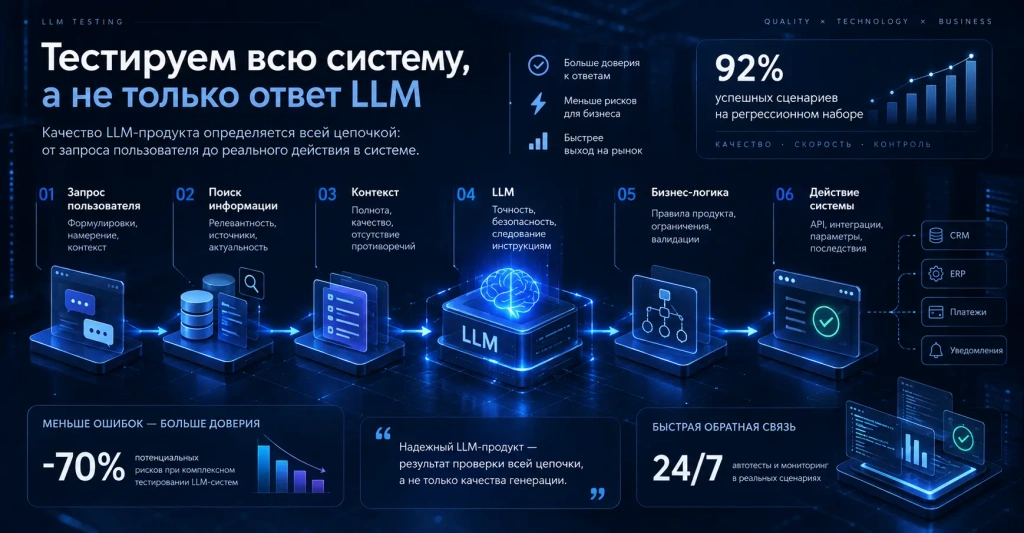
Поэтому LLM-продукт полезно рассматривать как единую цепочку и для каждого звена нужны свои проверки:
запрос пользователя → поиск информации → контекст → LLM → бизнес-логика → действие системы.
На уровне поиска важно понять, нашла ли система нужный документ и его актуальную версию. На уровне модели — правильно ли она использовала полученную информацию. На уровне бизнес-логики — соответствует ли результат правилам продукта. Если LLM получает возможность выполнять действия через API, отдельно проверяется выбор действия и передаваемые параметры.
Такой подход позволяет найти настоящую причину ошибки. Иначе любой странный ответ легко списать на модель, хотя проблема вполне может находиться в данных, поиске или интеграции.
Чем больше полномочий получает LLM, тем выше цена такой ошибки. Неточный ответ информационного чат-бота способен вызвать недовольство клиента. Ошибка AI-агента, который самостоятельно изменяет заказ, оформляет заявку или запускает корпоративный процесс, уже непосредственно затрагивает деньги и операции компании.
Уровень
Что может пойти не так
Что проверять
Запрос пользователя
Модель неверно понимает намерение
Разные формулировки, опечатки, неполные и неоднозначные запросы
Поиск информации
Найден нерелевантный или устаревший документ
Релевантность, актуальность и приоритет источников
Контекст
В LLM попадает недостаточная или противоречивая информация
Полноту контекста, конфликты между документами, отсутствие данных
LLM
Появляются галлюцинации или нарушаются инструкции
Фактическую точность, соответствие источникам и системному промпту
Бизнес-логика
Ответ противоречит правилам продукта
Тарифы, лимиты, статусы, права доступа, граничные условия
Действие системы
AI запускает неправильное действие
API-вызовы, параметры, подтверждения и последствия операции
Таблица. Что проверять на разных уровнях LLM-системы
Галлюцинации: почему убедительный ответ бывает опаснее явной ошибки
Галлюцинациями называют ситуации, когда языковая модель создает утверждения, которые выглядят достоверно, хотя не подтверждаются исходными данными.
Для бизнеса здесь есть дополнительная сложность: пользователь обычно не видит признаков технического сбоя. Ответ написан грамотно и уверенно, поэтому ему легко поверить.
В AI Index 2026 Стэнфордского университета приводятся результаты нескольких исследований надежности LLM. В одном из новых тестов показатели галлюцинаций у 26 ведущих моделей находились в диапазоне от 22% до 94% в зависимости от модели. В специализированном тесте на достоверность суммаризации результаты лучших моделей были значительно выше: доля галлюцинаций составляла примерно 1,8–5,4%.
На первый взгляд цифры противоречат друг другу. На деле они показывают важную особенность тестирования LLM: универсального показателя «точности модели» практически нет. Результат сильно зависит от задачи, контекста и методики проверки.
Для CTO или владельца продукта из этого следует вполне практический вывод. Даже показатель 98% мало о чем говорит, пока неизвестно, какие именно 2% запросов система обрабатывает неправильно.
Если ошибки приходятся на вопросы о погоде, последствия одни. Если это условия договора, платежи, медицинская информация или управление корпоративной системой — совсем другие.
Поэтому при тестировании полезно специально создавать ситуации, в которых информации недостаточно. Что произойдет, если пользователь спросит о продукте, которого нет в базе? Как поведет себя модель, если два документа противоречат друг другу? Что она сделает, если найдет инструкцию трехлетней давности рядом с действующей?
Еще интереснее ситуация, когда каждое отдельное требование кажется модели понятным, однако выполнить их вместе оказывается трудно. EnterpriseRAG benchmark (бенчмарк) 2026 года моделирует именно условия корпоративных систем: шум в найденных документах, пробелы в знаниях и противоречивые источники. В исследовании модели выполняли около 80% отдельных ограничений, но полностью соблюдали все требования одновременно только в 26,8% ответов.
Это уже очень похоже на реальную корпоративную среду, где документы редко бывают идеально подготовлены специально для LLM.
Одна из самых важных частей тестирования — проверка границ знания системы. Хороший результат иногда заключается в том, что модель понимает: надежного ответа сейчас нет.
Один вопрос стоит задавать по-разному
Пользователи редко формулируют запросы так, как предусмотрено тест-кейсом.
«Как вернуть товар?», «Хочу оформить возврат», «Купил неделю назад, передумал», «Можно это обратно отправить?» — для человека смысл почти одинаков. Для модели формулировка и предыдущий контекст диалога способны изменить результат.
Один важный бизнес-сценарий стоит проверять в разных вариантах: с опечатками, разговорными формулировками, неполными вопросами и лишним контекстом.
Особенно полезны граничные значения. Если возврат разрешен в течение 14 дней, проверяем 13-й, 14-й и 15-й день. Если скидка начинается с 10 000 рублей — 9 999, 10 000 и 10 001.
Качество LLM нужно измерять
Фраза «ассистент отвечает хорошо» для промышленной системы практически бесполезна.
Команде нужен контрольный набор реальных сценариев, по которому сравниваются версии модели, промптов и базы знаний. Для каждого сценария определяются критерии: корректность фактов, соответствие источникам, выполнение инструкции, безопасность и успешность бизнес-действия. После значимых изменений этот набор прогоняется повторно.
Это позволяет увидеть ситуацию, когда новая модель улучшила ответы службы поддержки, но стала хуже справляться с тарифами или сложными многошаговыми запросами. Такой подход важен и при использовании AI внутри самого QA: эффективность стоит оценивать по влиянию на качество и бизнес-результат, а не по количеству автоматически созданных артефактов. Подробнее об этом мы писали в материале «Как внедрить AI в QA без ложной автоматизации».
Цена и скорость тоже входят в качество
Каждый запрос к коммерческой LLM имеет стоимость. Поэтому при нагрузочном тестировании
имеет смысл измерять количество токенов, задержку, стоимость одного обращения и стоимость завершенного пользовательского сценария.
Особенно важно следить за этим после изменения промптов, подключения новых источников к RAG и увеличения контекстного окна. Пользователь может вообще не заметить изменений, хотя стоимость обработки одного запроса вырастет.
При большом количестве обращений такая разница быстро превращается из технической детали в статью расходов.
Хороший пример того, насколько тестирование AI-систем отличается от обычной функциональной проверки, есть в практике «Точки качества».
Команда участвовала в приемочном тестировании AI-чат-бота крупной авиакомпании перед его запуском. Здесь было недостаточно проверить, открывается ли чат, отправляются ли сообщения и отвечает ли сервер. Главный вопрос состоял в качестве самого диалога.
Специалисты проверяли сценарии общения и ответы бота, анализировали базу знаний, выявляли некорректные и неадекватные ответы. В процессе работы был сформирован датасет почти из 9 000 строк, который использовался для дообучения AI-модели.
Этот проект хорошо показывает еще одну особенность LLM-тестирования. Найденный дефект может выглядеть совсем иначе, чем в обычном приложении. Пользователь не увидит ошибку 500 или сломанную кнопку. Он получит вполне убедительный ответ, который плохо соответствует вопросу, контексту или правилам компании.
Для массового клиентского сервиса это особенно чувствительно. После публичного запуска каждый такой ответ становится частью клиентского опыта и напрямую влияет на отношение к продукту.
Поэтому проверка LLM перед продакшеном должна отвечать на более широкий вопрос: что произойдет, когда модель встретится с реальными пользователями и их непредсказуемыми формулировками?
После релиза тестирование продолжается
LLM-система может хорошо пройти приемку и начать ошибаться через несколько месяцев.
Меняются документы, тарифы, продукты и пользовательские запросы. Обновляются модели и механизмы поиска. Иногда небольшой правки системного промпта достаточно, чтобы изменить поведение сразу в нескольких сценариях.
Поэтому реальные диалоги пользователей стоит регулярно превращать в новые регрессионные тесты.
Что проверить перед запуском LLM-системы: чек-лист
Перед выходом в продакшен стоит проверить:
реальные пользовательские формулировки, включая опечатки и неоднозначные вопросы;
сценарии, для которых в базе знаний нет ответа;
устаревшие и конфликтующие документы;
качество поиска отдельно от качества генерации;
критические бизнес-действия, которые может инициировать LLM;
контрольный набор запросов для регрессионного тестирования;
задержку, количество токенов и стоимость сценариев;
механизм добавления реальных ошибок пользователей в регрессионный набор.
Что в итоге
Зрелое тестирование LLM-систем строится вокруг четырех вещей: качества ответа, надежности источников, устойчивости бизнес-сценариев и постоянного контроля после релиза.
Источники
Stanford Institute for Human-Centered AI. AI Index Report 2026.
Miao H., Sun X., Wang B. et al. EnterpriseRAG: Benchmarking LLM Instruction Adherence and Robustness under Non-Ideal Enterprise Retrieval, 2026.
FAQ: частые вопросы о тестировании LLM-систем
Чем тестирование LLM-систем отличается от обычного тестирования ПО?
В обычном ПО результат действия чаще всего можно заранее определить однозначно. LLM способна по-разному ответить на один и тот же вопрос, поэтому проверять приходится не только техническую работоспособность системы, но и точность ответа, его соответствие источникам, контексту и бизнес-правилам. Если модель может самостоятельно выполнять действия, в область тестирования также входят API, интеграции и последствия принятых ею решений.
Что нужно тестировать в системе с LLM?
Проверять стоит всю цепочку работы продукта: запрос пользователя → поиск информации → контекст → LLM → бизнес-логика → действие системы. Ошибка на любом из этих этапов способна привести к неправильному результату, даже если сама языковая модель отработала корректно.
Как тестировать LLM на галлюцинации?
В тестовый набор нужно включать вопросы с известными ответами, запросы с недостатком информации, противоречивые данные и ситуации, для которых ответа в базе знаний вообще нет. Важно проверить, умеет ли система корректно работать с неопределенностью и не создает ли убедительный ответ там, где достоверных данных недостаточно. В статье этот риск особенно важен, поскольку показатели галлюцинаций заметно меняются в зависимости от задачи и методики оценки.
Как тестировать RAG-системы?
В RAG-системах качество поиска и качество генерации желательно оценивать отдельно. Сначала проверяется, нашла ли система релевантный и актуальный источник, затем — правильно ли LLM использовала полученный контекст. Отдельного внимания требуют устаревшие документы, противоречащие друг другу источники и ситуации, когда нужной информации в базе знаний нет.
Можно ли автоматизировать тестирование LLM?
Да, особенно регрессионные проверки. Для продукта формируется контрольный набор из реальных запросов и критичных бизнес-сценариев, который повторно прогоняется после изменения модели, промпта, базы знаний или механизма поиска. При этом часть результатов может требовать дополнительной экспертной оценки, поскольку качество ответа не всегда сводится к простому «верно/неверно».
Какие метрики использовать для оценки качества LLM-системы?
Набор метрик зависит от продукта. Обычно стоит учитывать фактическую точность ответов, соответствие источникам, выполнение инструкций, качество поиска, долю успешных бизнес-сценариев, количество критических ошибок, задержку ответа и стоимость обработки запроса. Для клиентских систем также полезно отслеживать повторные обращения и ситуации, когда диалог приходится передавать человеку.
Нужно ли тестировать LLM после запуска продукта?
Да. Поведение системы может измениться после обновления модели, промпта, документов, базы знаний или алгоритма поиска. Кроме того, реальные пользователи находят формулировки и сценарии, которые сложно полностью предусмотреть до запуска. Поэтому проблемные диалоги из промышленной среды стоит регулярно анализировать и добавлять в регрессионный набор.
Когда LLM-систему можно считать готовой к запуску?
Единого показателя готовности нет. Решение зависит от допустимого риска конкретного продукта. Чем серьезнее последствия ошибочного ответа или действия модели, тем строже должны быть критерии приемки. Для системы, которая только помогает искать информацию, и AI-агента, способного проводить операции через API, приемлемый уровень риска будет разным.